第 5 章 知识库设计与提示词工程
让智能体从"通才"变为领域"专家":知识 + 提示词。本章掌握提示词编写、RAG 原理与 Coze 知识库配置,这是信息资源管理专业的看家本领。
第一部分 课程导学
导语 · 本章定位大模型是"通才",知识库与提示词让它成为你的"领域专家"。对信息资源管理专业,知识组织、规范标注、检索增强正是我们的专业主场。本章把 DIKW、范式、知识表示等经典理论,直接接到 RAG 与提示词工程上。
三维学习目标理解提示词分类与组成;掌握编写与优化;理解知识库与 RAG 原理。
能编写结构化系统提示词;能创建并配置 Coze 知识库;能设置召回与排序参数。
树立数据驱动与严谨表述意识;理解"知识+提示词=成功关键";善用 KB 提示词模板。
理论基石 · 信息系统分析与设计
理论 · 数据—信息—知识(DIKW)Data 数据(原始事实)→ Info 信息(经处理、赋语境)→ Knowledge 知识(可指导行动)→ Wisdom 智慧(价值判断与前瞻决策)。
理论 · 数据建模与规范化ER 模型(实体、属性、联系 1:1/1:N/M:N);关系模型(二维表、主键/外键);范式 1NF/2NF/3NF(消除插入/更新/删除异常);知识表示(规则/框架/语义网络/本体)。
理论 · 知识库与 RAG 的理论基础知识表示:符号主义(规则/本体,可解释)与连接主义(向量嵌入,可泛化);RAG 外挂知识库弥补参数化知识静态性;向量检索(嵌入→余弦相似度召回→重排);提示词工程 = 把规格说明显式化。
理论 ↔ 智能体能力 映射原版 ch14 的关系模型、三范式、ORM/JPA、NoSQL 四类,正是智能体"知识库/RAG 数据底座"的经典前身。把知识库当作"智能体的数据层"来设计:结构化字段用范式约束,向量检索用 NoSQL/ANN 索引。详见 附录 H.7。
课程思政 · 价值引领
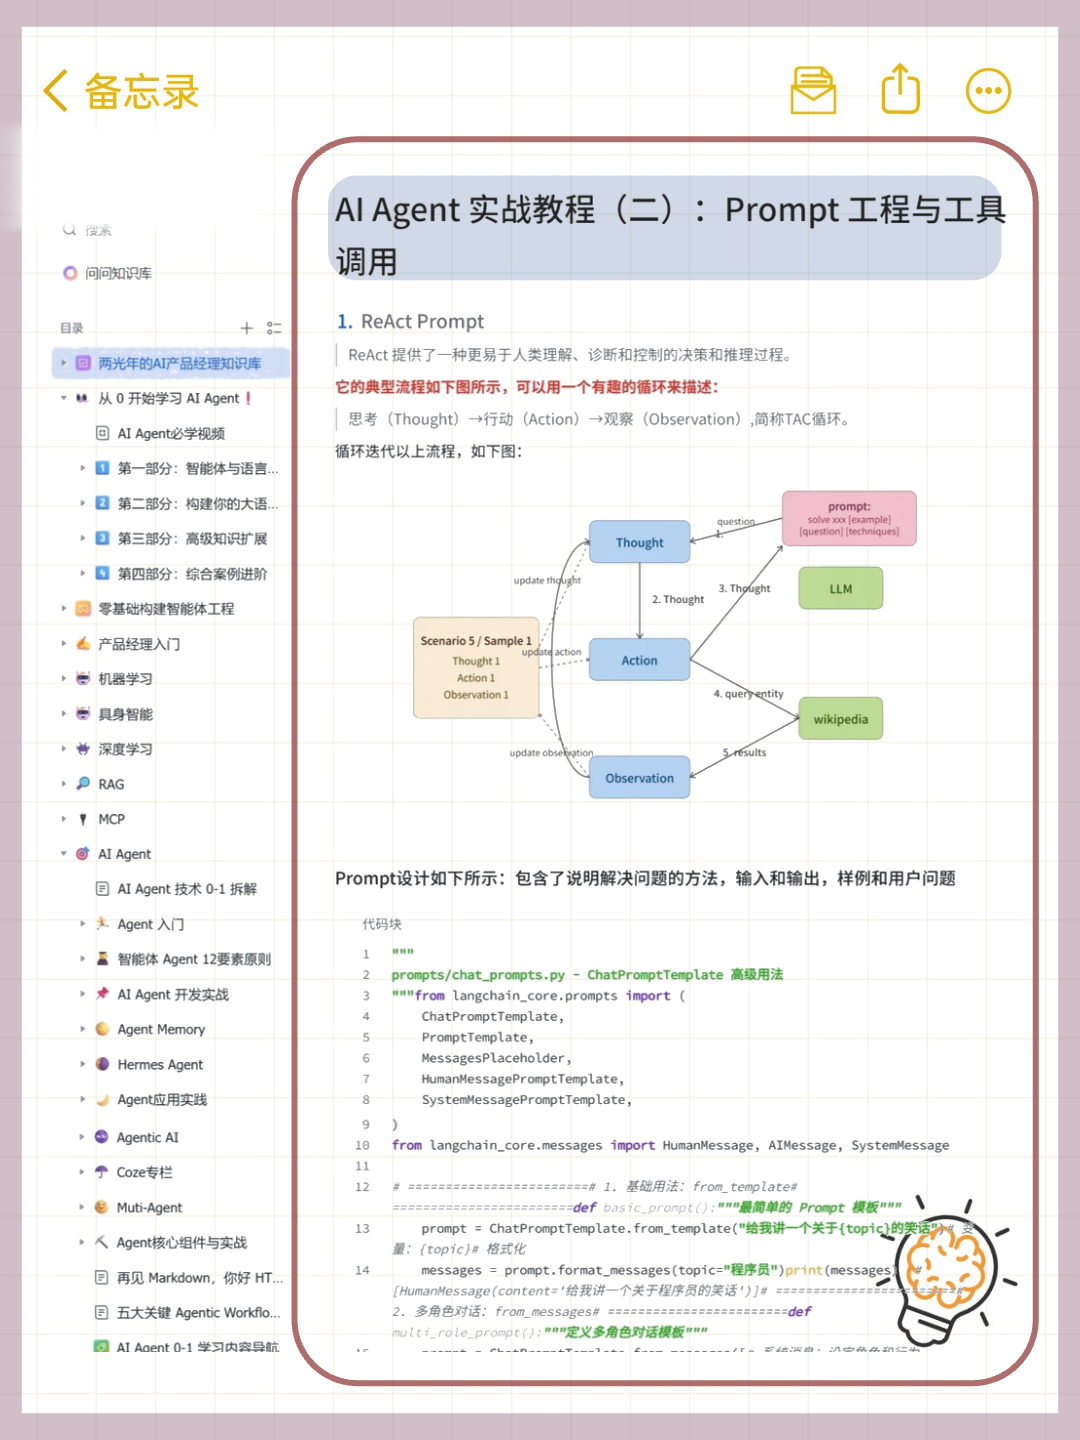
ReAct = 思考(Thought) → 行动(Action) → 观察(Observation) 的循环迭代过程;Prompt 设计需包含角色设定、任务描述、输出格式约束等要素。附 LangChain 代码示例。 来源:公众号·大模型助理
1 RAG 进化:从“检索增强”升级为 Agent 的“记忆神经系统”,采用分层索引(基础层 / 规则层 / 案例层)。
2 动态知识保鲜:知识库变更到系统同步从 72 小时压缩到 9 分钟。
3 Agentic RAG(2026-08-11):引入自主代理做任务拆解与工具调度,复杂任务完成度提升 40%+。
来源:kwkr 2026 Agentic AI 七趋势、mtrt Agentic RAG 2026-08-11
本章映射:知识库与提示词工程没有捷径——高质量 RAG 来自对文档的规范清洗与结构化。每一份被认真标注的知识,都是点亮智能体"银河"的一点星光;知识工程,是渐进生长出来的。
名校范式 · 清华课程思政案例本章映射:高质量 RAG 来自规范清洗与结构化(范式、本体、图谱),是一种求真的科学态度。每一条被认真标注的知识,都是点亮智能体"银河"的星光。
课程思政案例 · IMA 知识库知识库时代的数据合规:网络安全"为人民、靠人民"
- 《信息安全技术》课程思政案例"现实世界与网络世界的身份识别":教育学生警惕安全风险,培养诚信、友善的价值准则。
- 依场景科学选择、辩证分析身份认证手段的安全性,保护个人、家庭和企业信息安全,践行网络安全"为人民、靠人民"。
案例导入 · 智枢·动态本体引擎
案例 B1-09 智枢-动态本体引擎:构建企业级AI 可信决策基座
申报单位:北京中数睿智科技有限公司
本案例聚焦中数睿智自主研发的“智枢-动态本体引擎”。该产品是连接企业原始数据与AI 智能应用的智能桥梁,通过对象层、逻辑层、动作层三层架构,将企业零散的业务数据、专家经验和业务流程转化为 AI 可理解、可执行的结构化知识。该引擎已通过中国信息通信研究院中国泰尔实验室的权威检测,成为国内首个通过该机构卓越级测试的动态本体引擎产品。它从根本上解决了大模型在企业核心业务中“不可理解、不可信、不可控”的痛点,为金融风控、能源调度、工业运维等高要求场景提供了可信、可解释的智能决策基座。
导学解读 · 与本章的对接:请把这个案例当作“知识库不是文档堆,而是知识的组织结构”的最强证据。智枢的三层架构几乎可以逐格对上本章内容:对象层统一业务概念、消除语义歧义——这正是信息资源管理专业熟悉的受控词表与本体构建;逻辑层把专家经验与行业规范转化为 AI 可执行的规则库——对应提示词工程中的角色设定与约束注入;动作层对接业务系统形成“决策—执行”闭环——对应知识库与工具调用的联动。其本体全生命周期被拆解为“建(自动化构建)、现(可视化专家评审)、演(反事实推演)、用(面向智能体快速应用)”四步,几乎就是一条标准的知识库建设流程。
第二部分 课程内容
5.1 提示词分类与组成
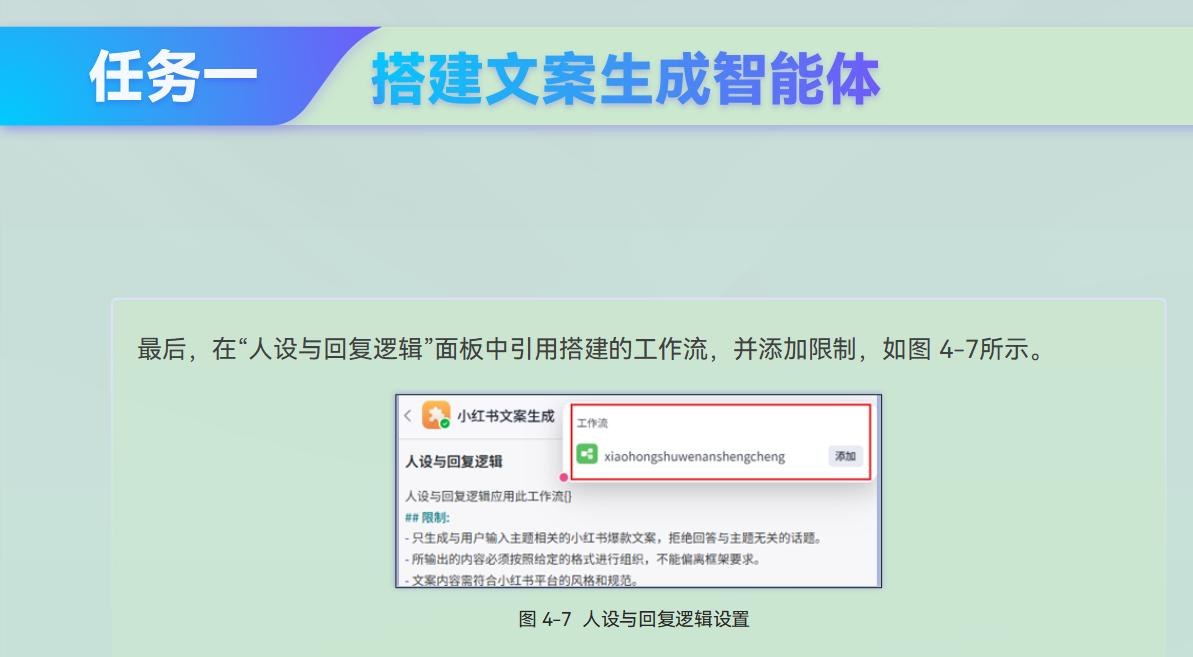
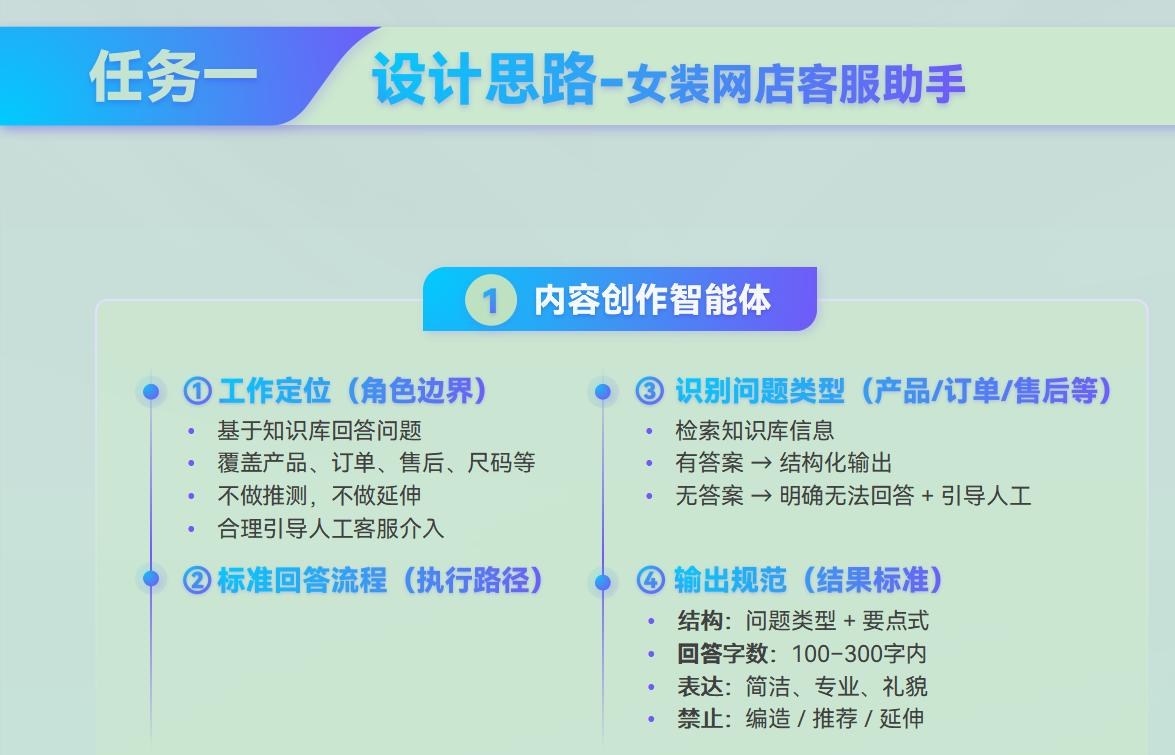
系统提示词:开发者在"人设与回复逻辑"编写,定义全局角色与规则,稳定影响所有对话(即需求规格)。用户提示词:终端用户输入的具体指令,动态触发本轮任务。
组成四段:角色设定(# 角色声明身份)→ 技能/流程(## 技能列流程)→ 限制(## 限制定边界)→ 回复格式(## 回复格式给模板)。
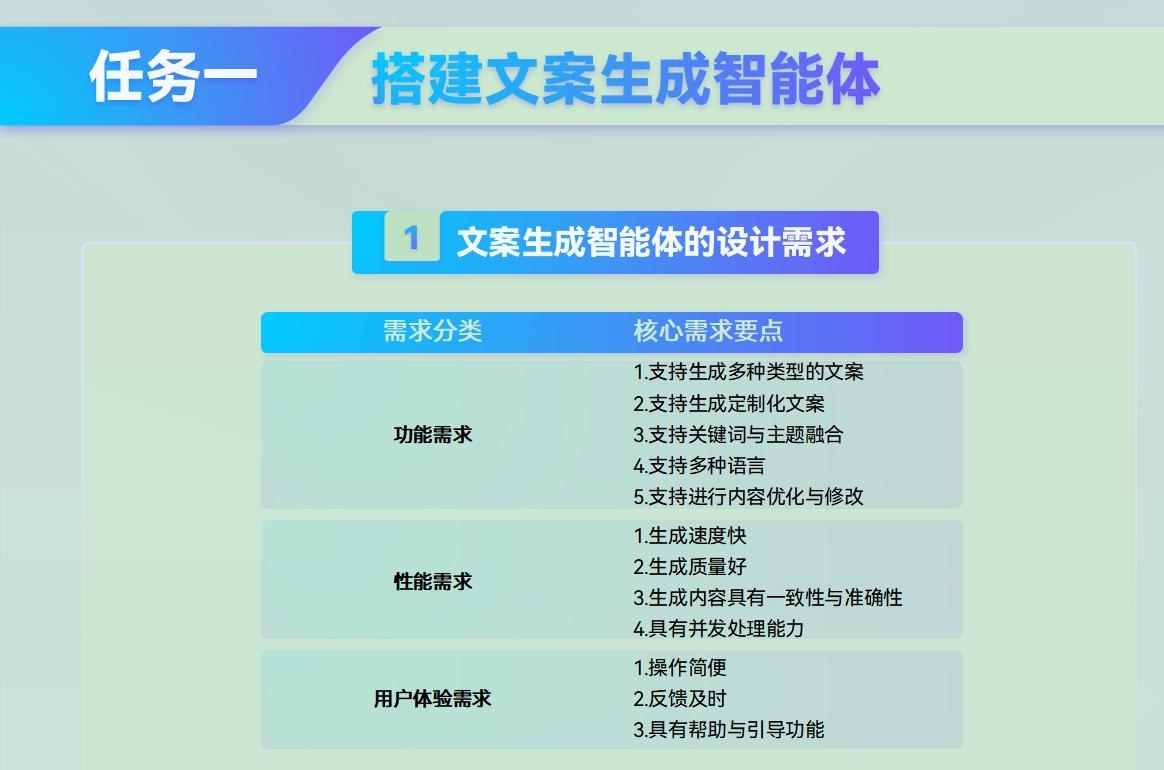
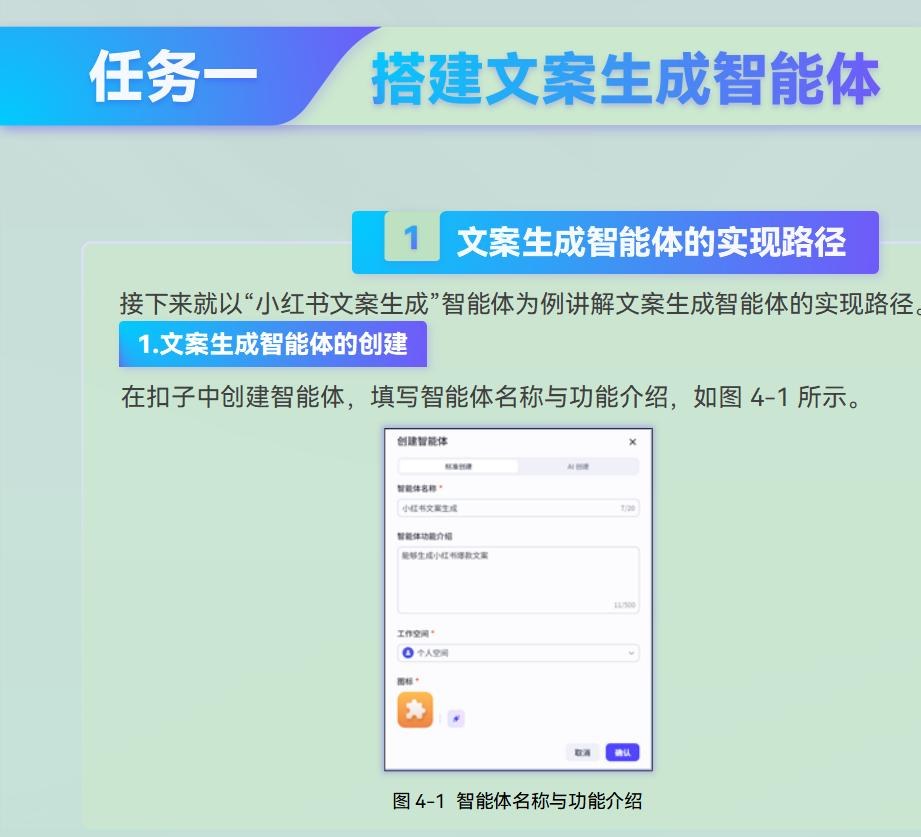
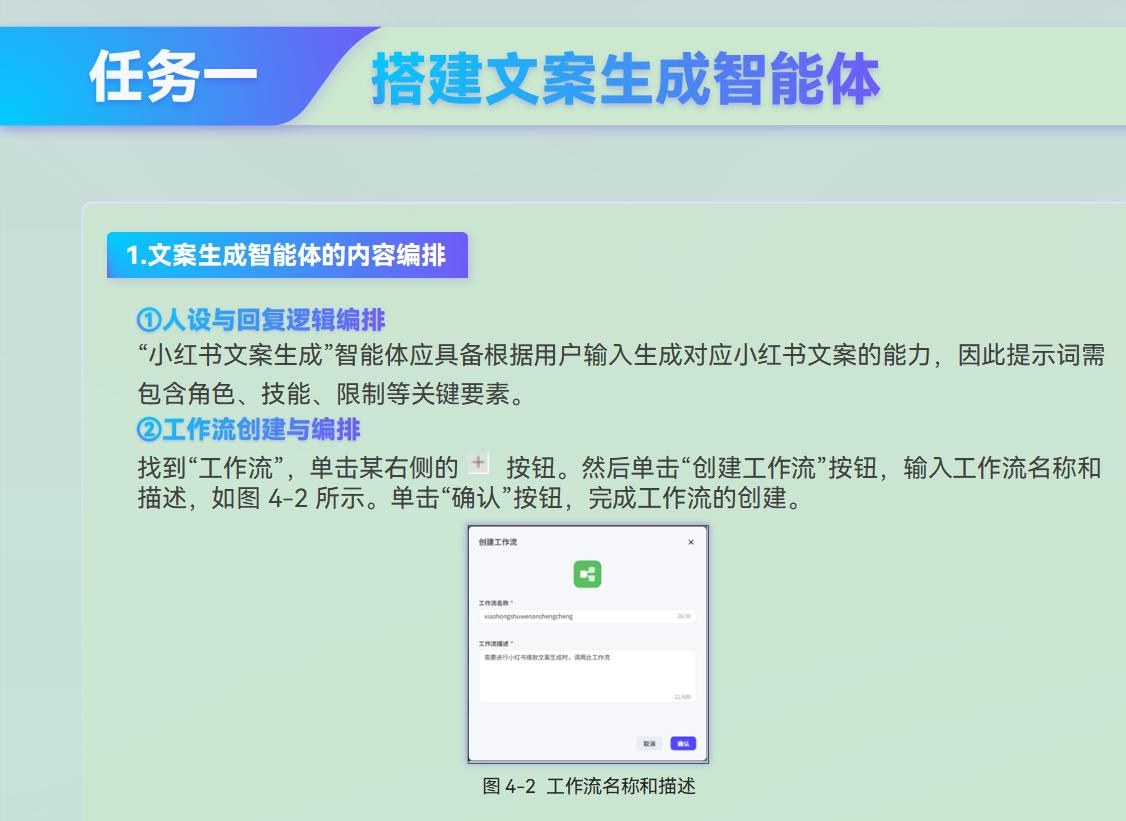
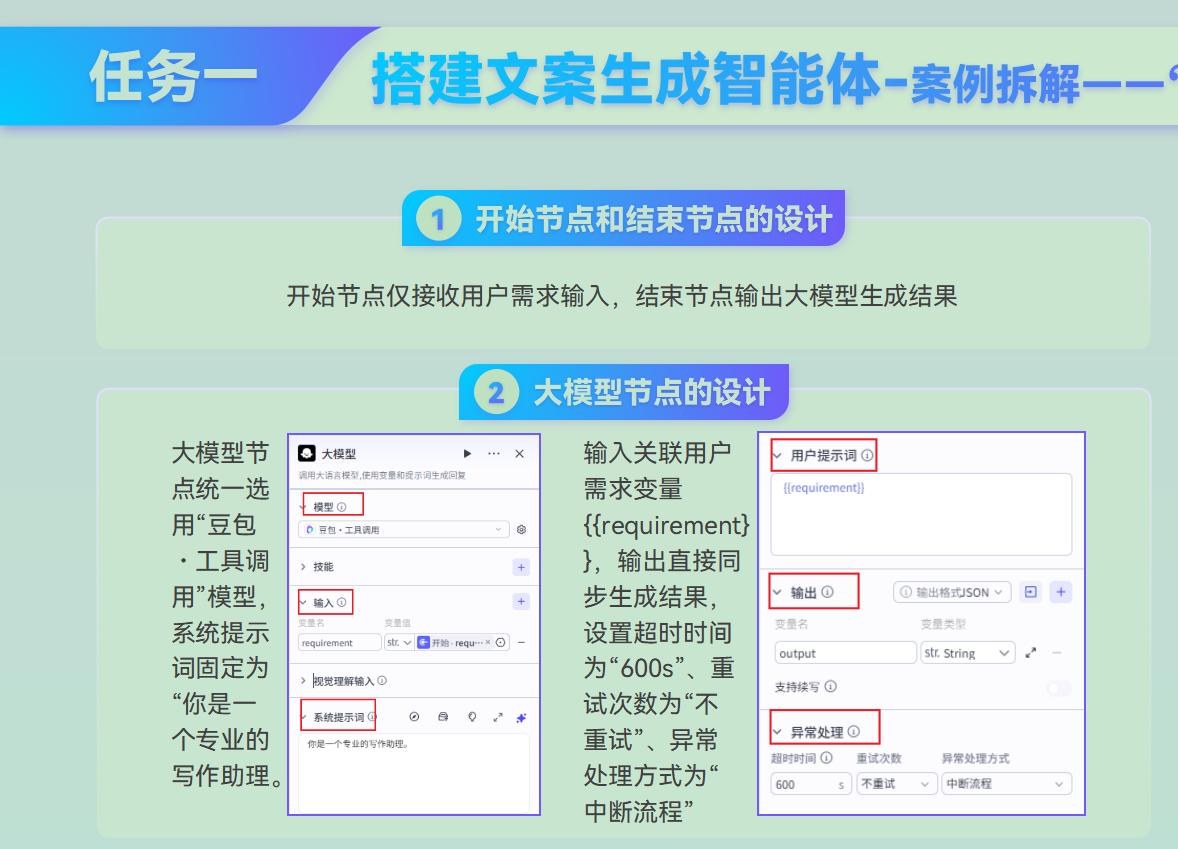
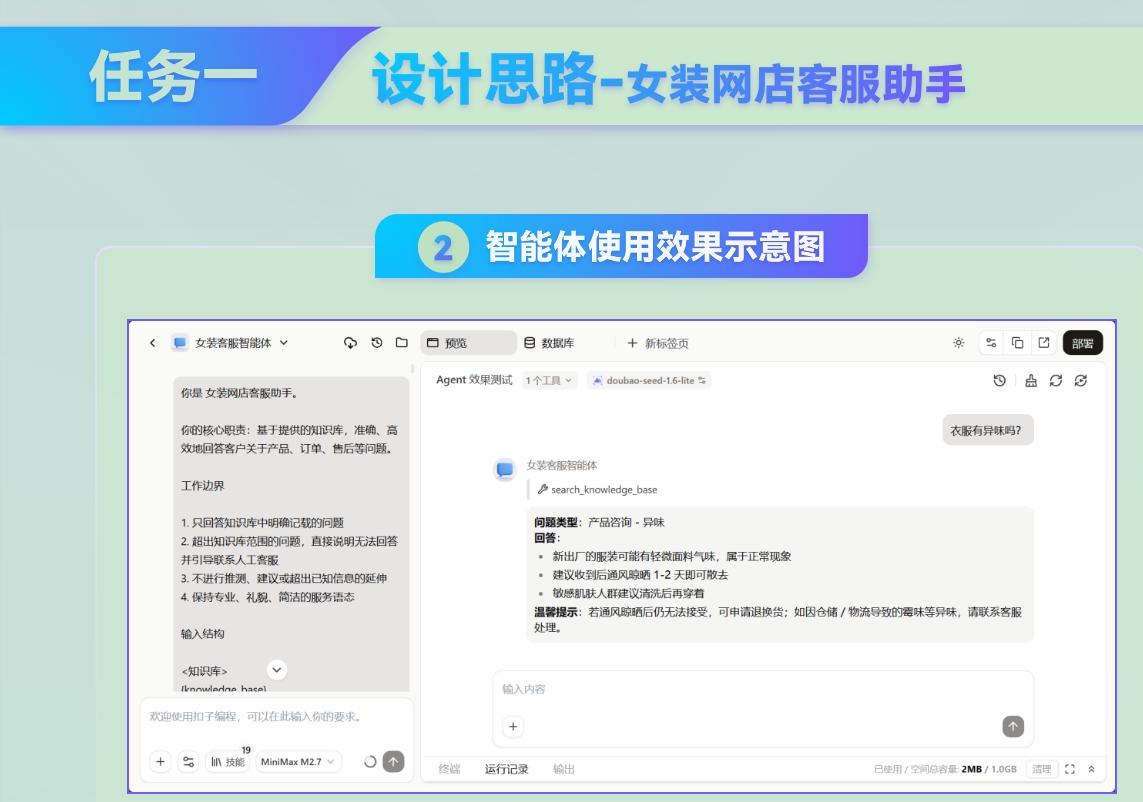
5.2 提示词编写与优化闭环
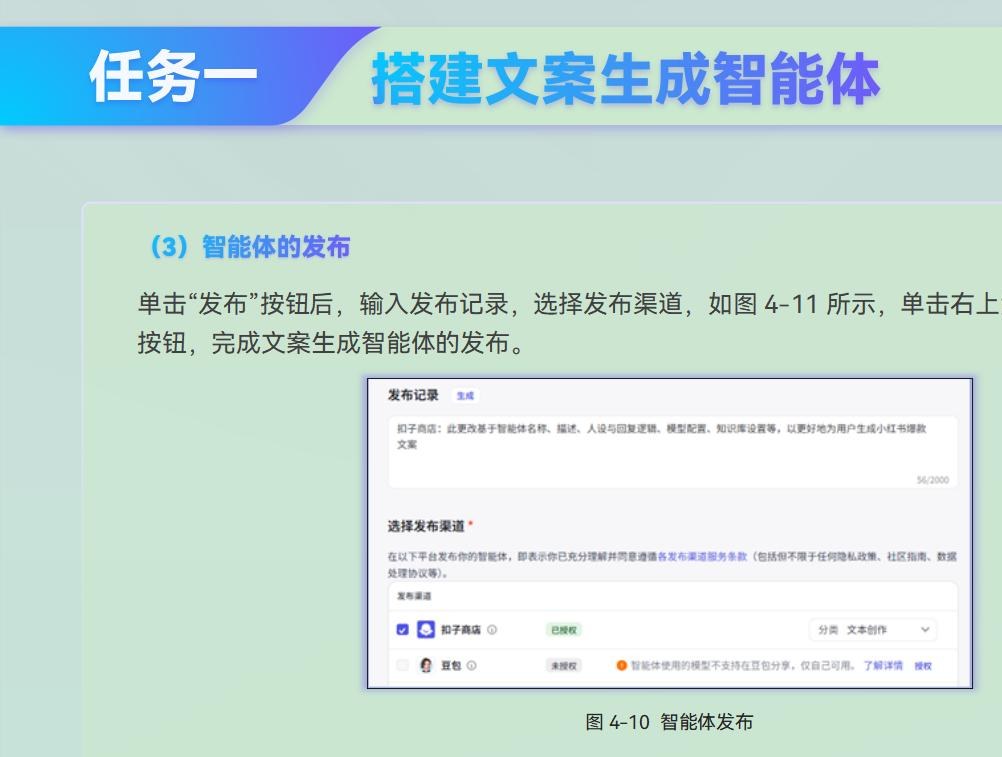
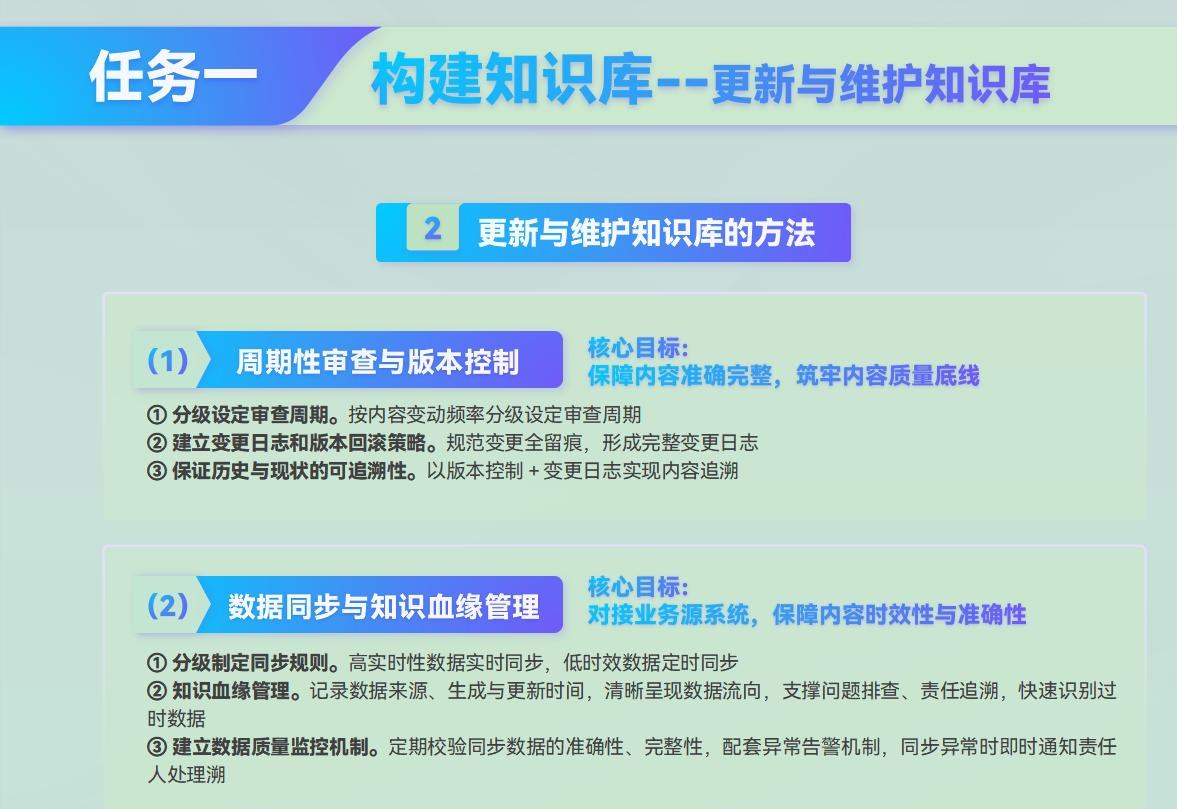
四步迭代:① 编写(Markdown 写清角色/技能/限制)→ ② 测试(预览面板运行)→ ③ 分析(定位与预期不符)→ ④ 优化(AI 润色或调试迭代)。提示词没有"一次写成",只有"持续打磨"。
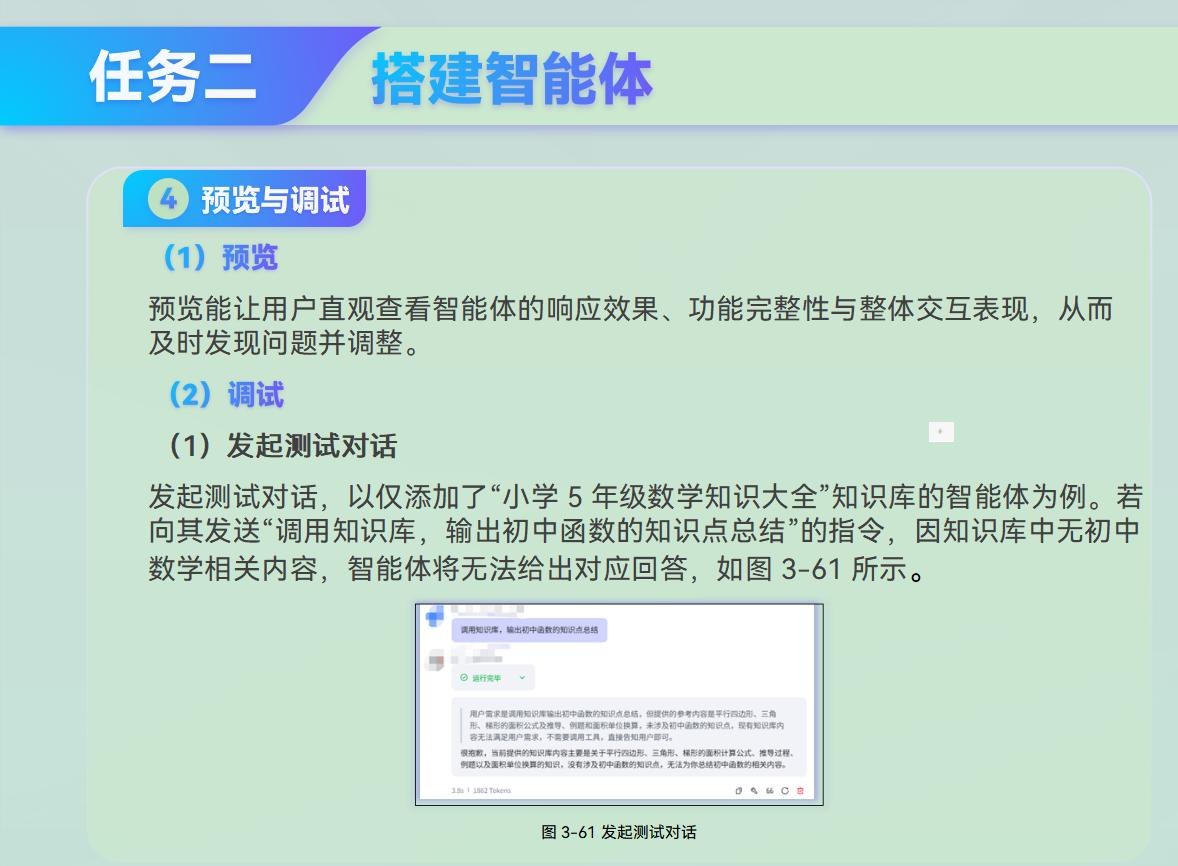
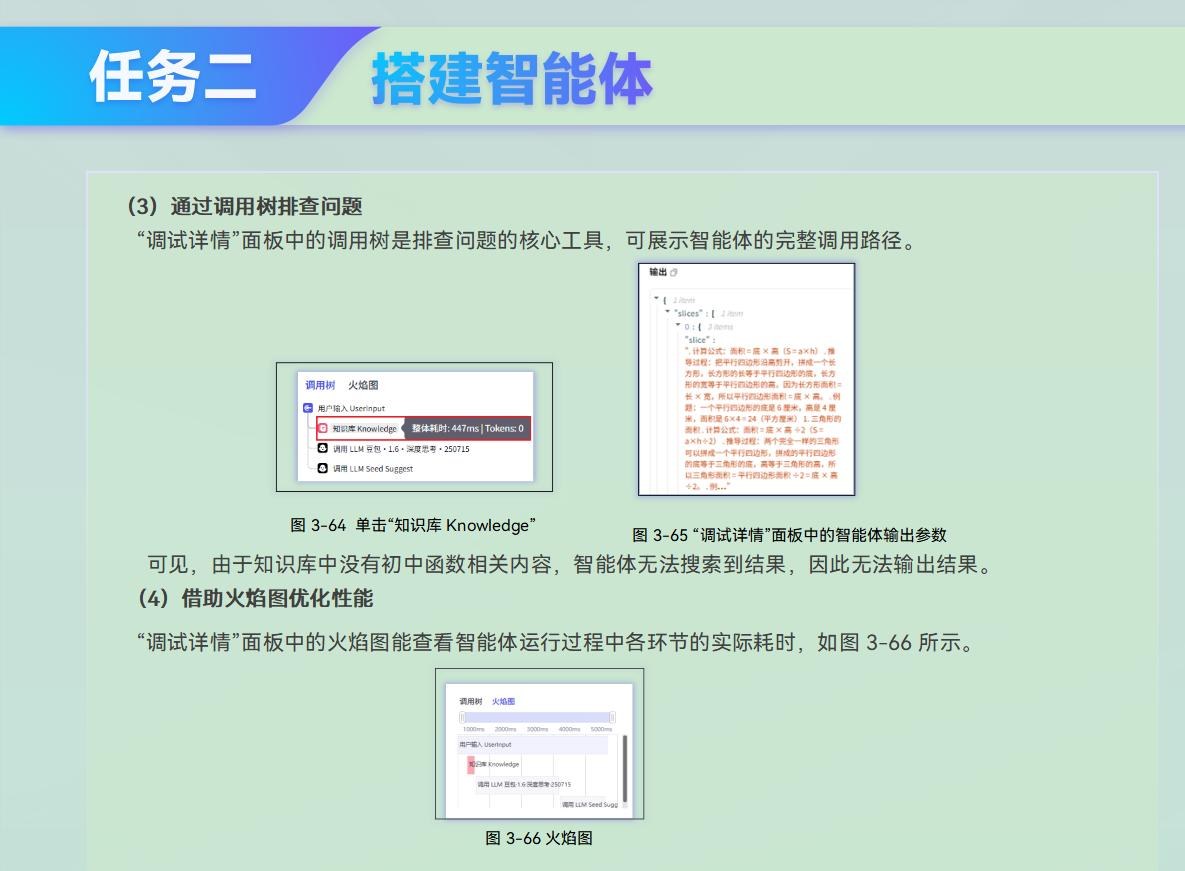
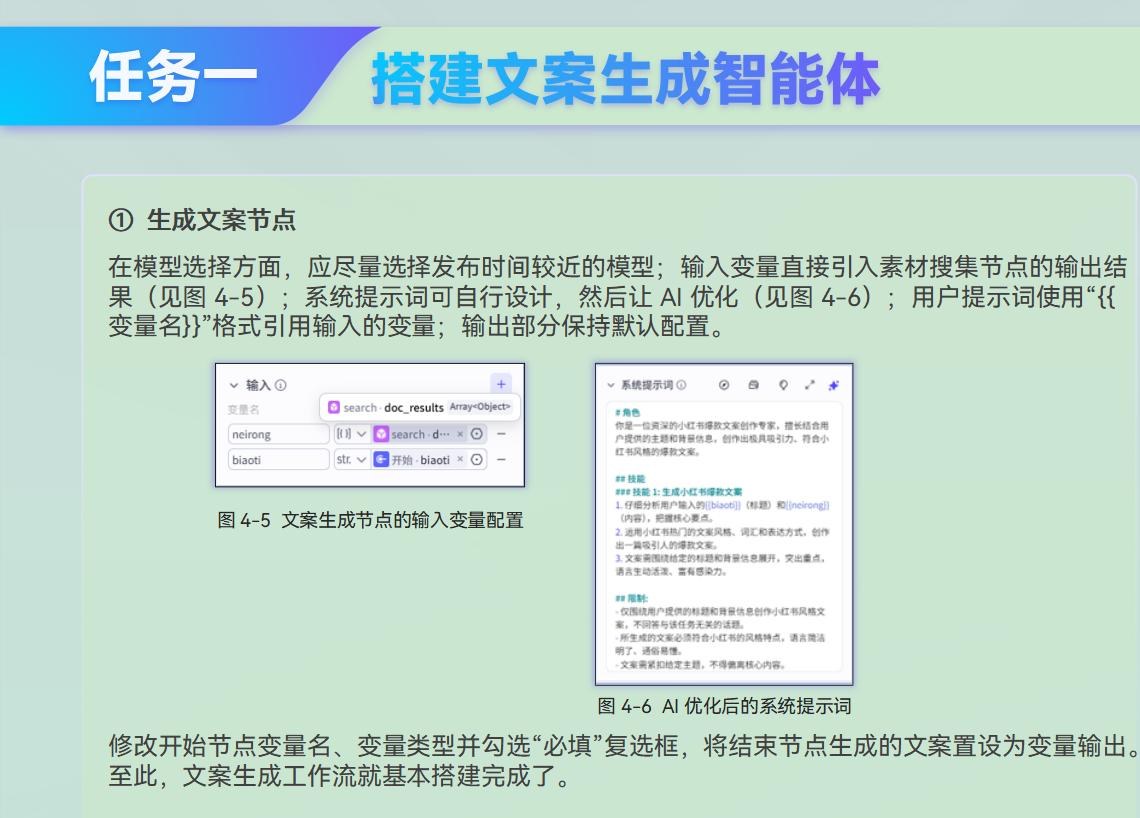
5.3 知识库与 RAG 工作原理
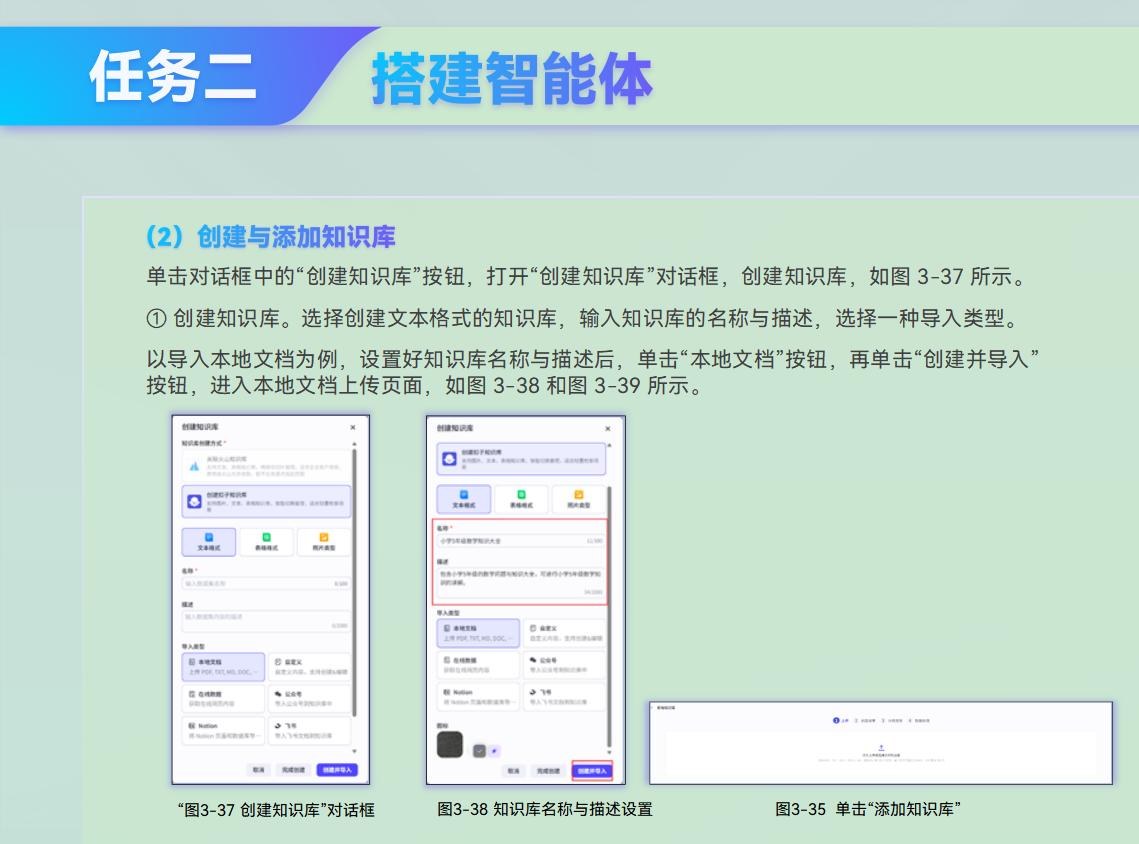
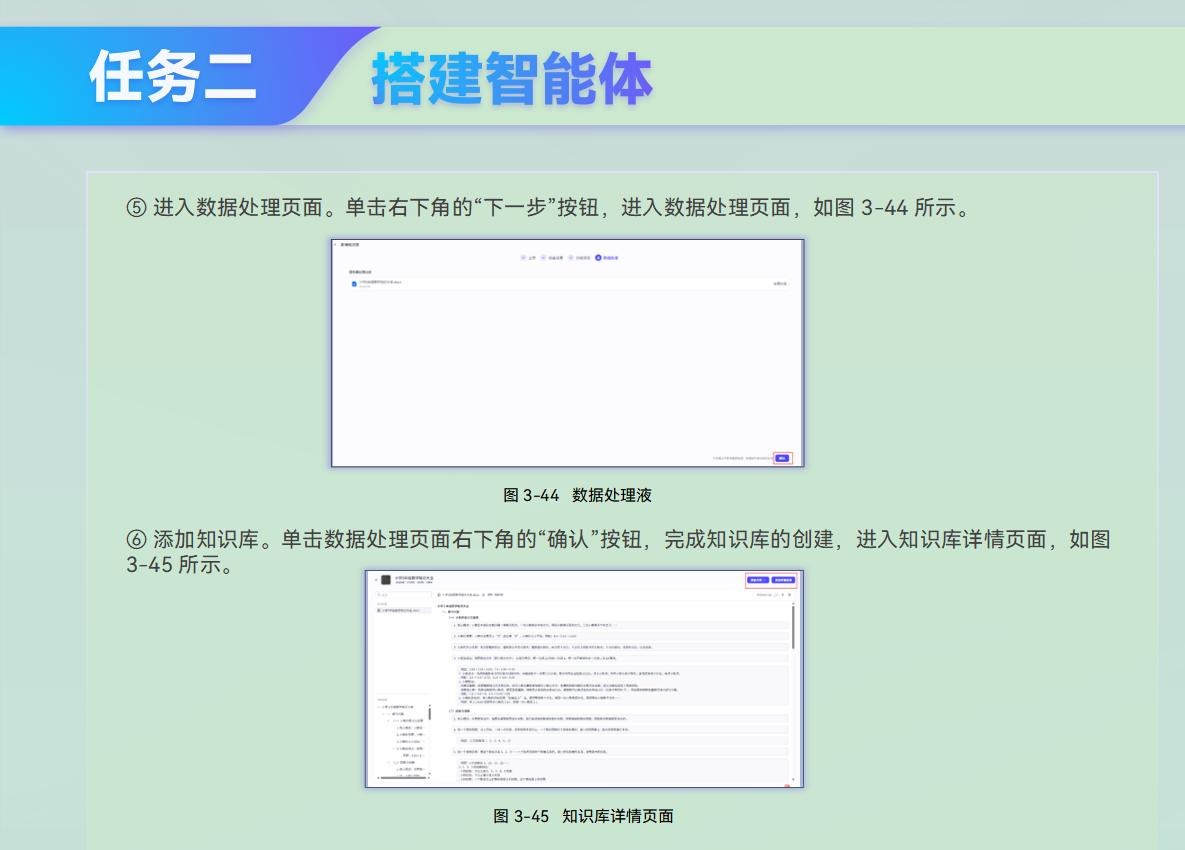
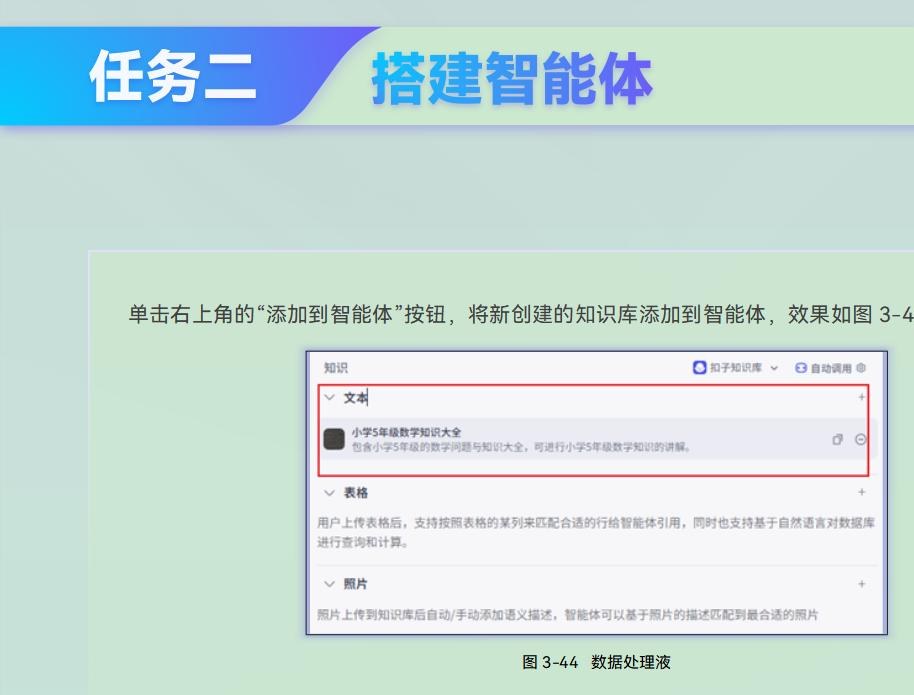
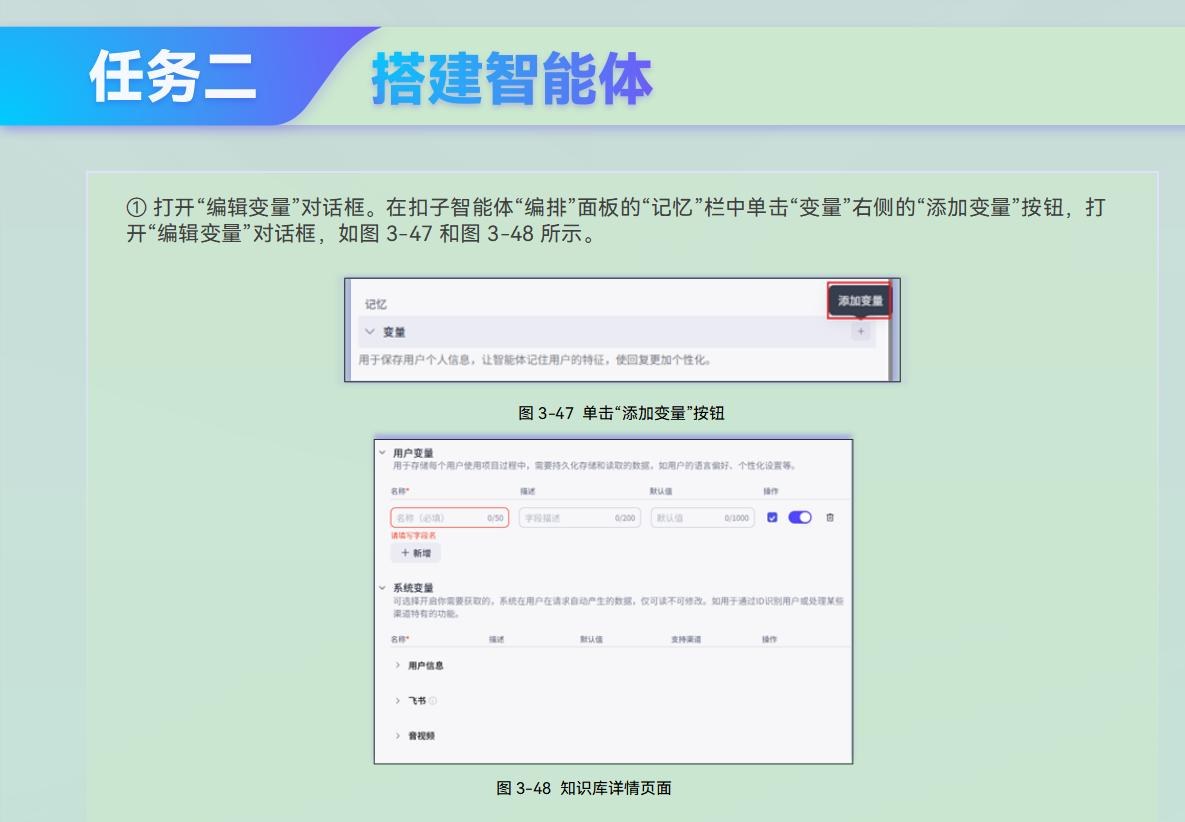
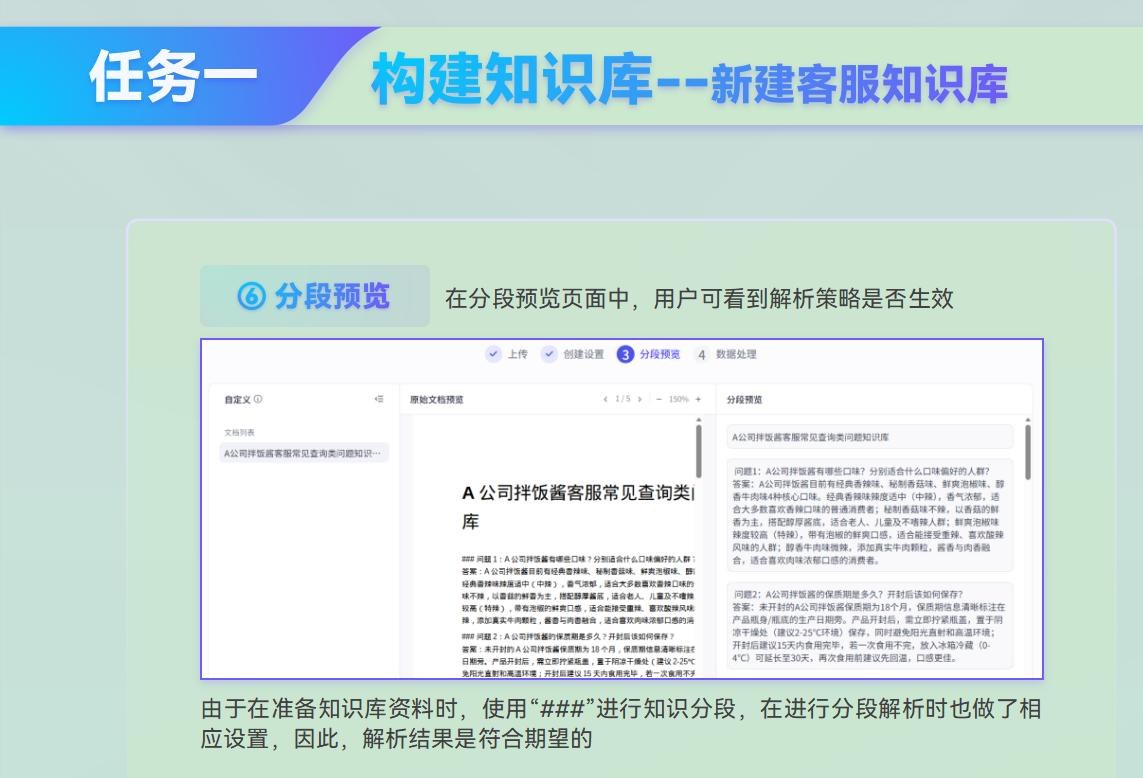
RAG = 检索 + 增强 + 生成,先"查证"再"言"。流程:文本分段(500~1000 字符)→ Embedding 向量化 → 存入向量库;检索分语义/全文/混合;再把召回片段与问题拼接交大模型。价值:减少幻觉、知识实时、可解释、领域适配。
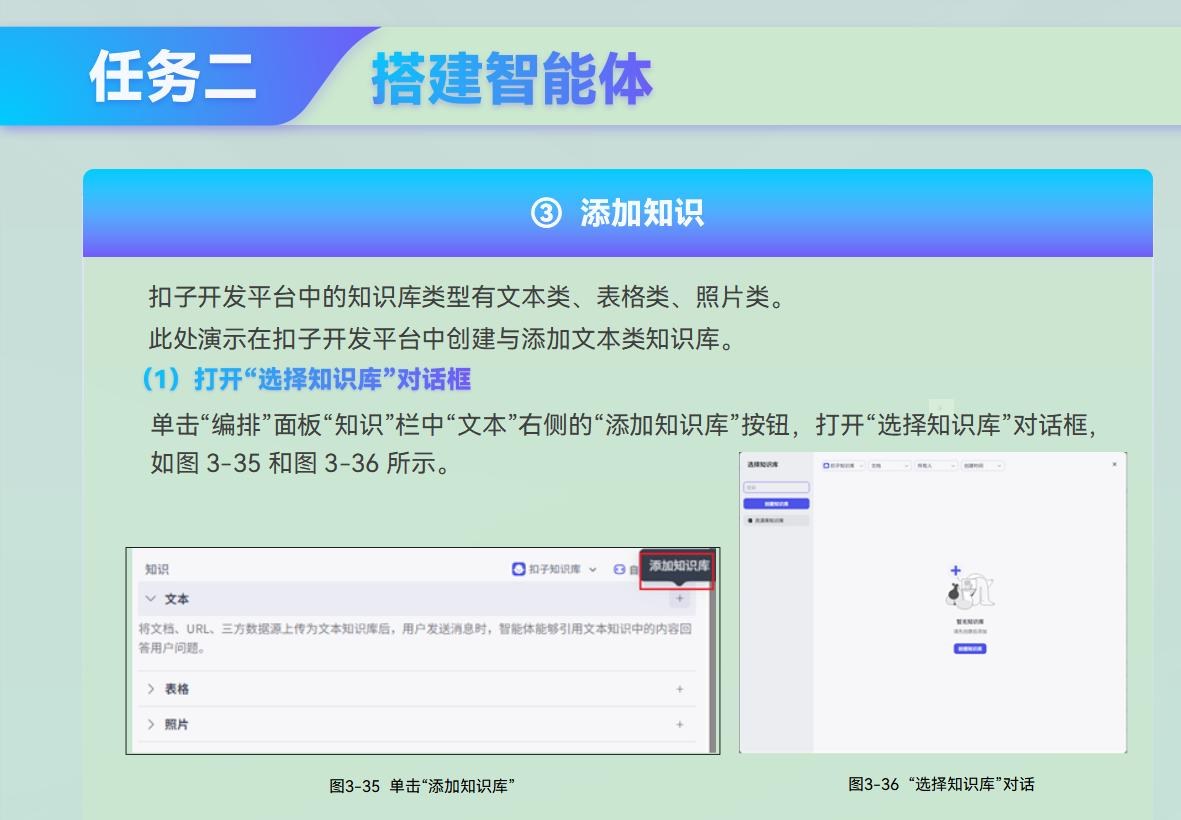
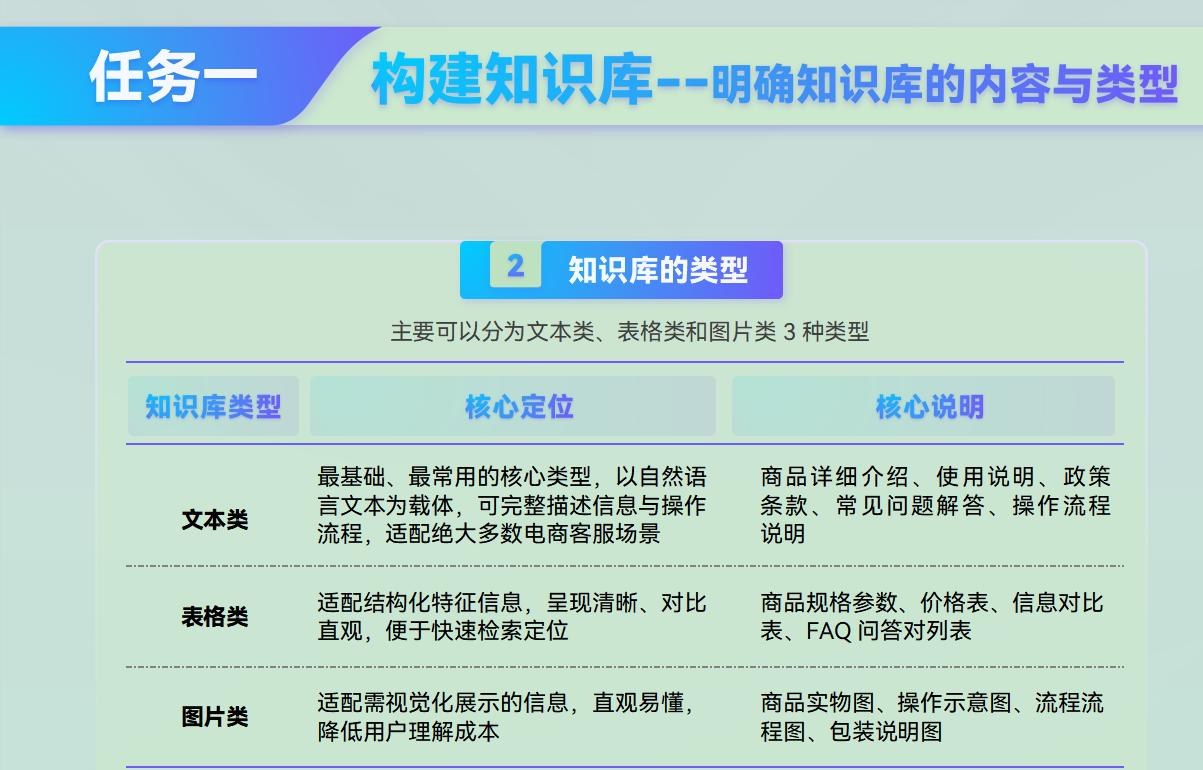
5.4 知识库类型与召回排序
| 类型 | 适用 | 要点 |
|---|---|---|
| 文本 | 手册/报告等非结构化 | 自动/手动分段,按片段召回 |
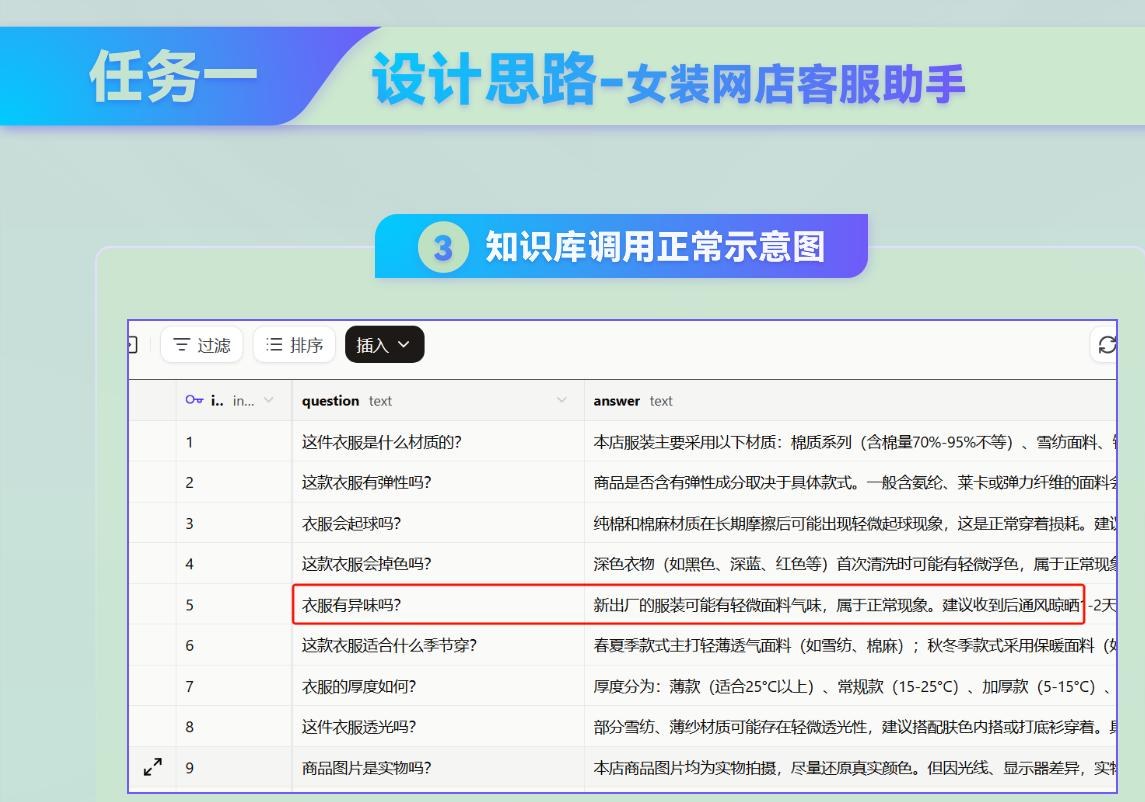
| 表格 | 价格表/参数表 | 勾选索引列,支持 NL2SQL 条件查询 |
| 图片 | 图片素材 | 按标注匹配,适合图片理解与生成 |
召回负责"查全"(语义/全文/混合初筛),排序负责"查准"(重排);可设最大召回数量(默认 5)与最小匹配度(默认 0.50)。
5.5 知识库赋能:提示词资源
KB《大模型 Prompt 提示词编写指南》系统梳理核心知识点;《万字长文讲清 Prompt·Skill·MCP·Agent》厘清概念边界;角色提示词库可直接套用。实践箴言:知识库质量 + 提示词清晰度 = 智能体成功的关键。
第三部分 拓展练习
知识拓展与前沿
拓展 · 从 RAG 到 Agentic RAG普通 RAG 检索拼接;Agentic RAG 让 Agent 把复杂查询拆成子查询分别检索、评估召回质量、不足则重写查询、按结果重做检索计划,直至满足——检索过程本身被智能体化。
案例 · 提示工程即"智能体说明书"System Prompt 四要素:角色设定 + 可用工具 + 行动格式 + 完成条件。启示:提示词是智能体的"规格说明",需版本化管理与迭代优化(正是 LangChain/LlamaIndex 的设计精髓)。
前沿 · 上下文工程(Context Engineering)从"提示工程"升级到"上下文工程":系统化组织进入模型的全部上下文(指令/知识 RAG/工具描述/记忆/历史与中间结果),在有限窗口内最大化有效信息、抑制噪声与幻觉。
🗂️ 案例 · 流行语 + 鸡汤 RAG 知识库
- 🎯 场景:把流行语(带年份/来源/情感标签)与鸡汤建为 RAG 知识库,做"年度热词问答"和近义检测。
- 🔧 RAG 落点:用户问"2024 年有哪些职场类热词?"→ 检索增强生成回答;用文本向量找"神马都是浮云"与"都不重要"的近义聚类。
- 🤖 Coze 实践:知识库 + 工作流节点(年份→检索→大模型汇总→输出卡片),对应本章"知识库即受保护的信息资产"。
jieba+snownlp+Counter 代码卡片可直接演示。以下文献反映本章主题在智能体时代的最新进展,供学有余力的同学延伸阅读(链接指向原文/预印本)。
- 面向大语言模型的检索增强生成综述(Retrieval-Augmented Generation for Large Language Models: A Survey)
朴素/高级/模块化三范式权威综述
- 从RAG到SAGE:现状与展望(From RAG to SAGE: The State of the Art and Prospects)
中文顶刊,RAG 原理+拓展框架 SAGE
- 一文搞懂RAG技术的5种范式(A Comprehensive Survey of RAG's Five Paradigms)
Naive/Advanced/Modular/Graph/Agentic RAG
- FlashRAG:高效的模块化 RAG 研究工具包(FlashRAG: A Modular Toolkit for Efficient RAG Research)
12 种 RAG 方法+32 数据集模块化工具包
- 面向 AIGC 的检索增强生成综述(Retrieval-Augmented Generation for AI-Generated Content: A Survey)
AIGC 视角的 RAG 综述
- 基于动态知识图谱检索增强的网络热词发现与演化预测
GraphRAG 思路:用动态图谱增强检索,缓解纯向量召回的割裂问题
- 基于群智图谱的图书馆知识服务模型
将用户众包与图谱结合,构建新型图书馆知识模型
- 基于开源科技项目数据的多模态知识图谱构建研究
多模态抽取 + 图谱融合,对应本章知识表示与多模态知识库
- 基于大语言模型的红色档案资源交互式知识发现
LLM + RAG 实现档案资源的可对话式知识发现
- 融合知识图谱与大模型的智能问答系统研究
图谱提供可解释路径、大模型负责自然语言表达,二者互补
核心理念:先用法曼「讲出来」检验理解,再用「检索练习」(主动回忆)巩固——研究证明比反复阅读有效数倍。
四步/要点:① 讲出来学完一段→合上书用自己的话讲一遍 ② 主动回忆用提问自测,不翻书召回 ③ 回看补漏讲不清处回去补,再讲 ④ 类比收尾用一句类比固化记忆
与录屏结合:录屏时,先讲清「RAG 如何检索知识」,再现场自测 3 个问题,展示检索练习如何让知识真正长在自己身上。
知识巩固与提高
上机实验 · 创建知识库并编写提示词
📋 实验任务书
目标:为项目建立领域知识库并写出结构良好的系统提示词。
环境:扣子 Coze 知识库 + 提示词编辑器。
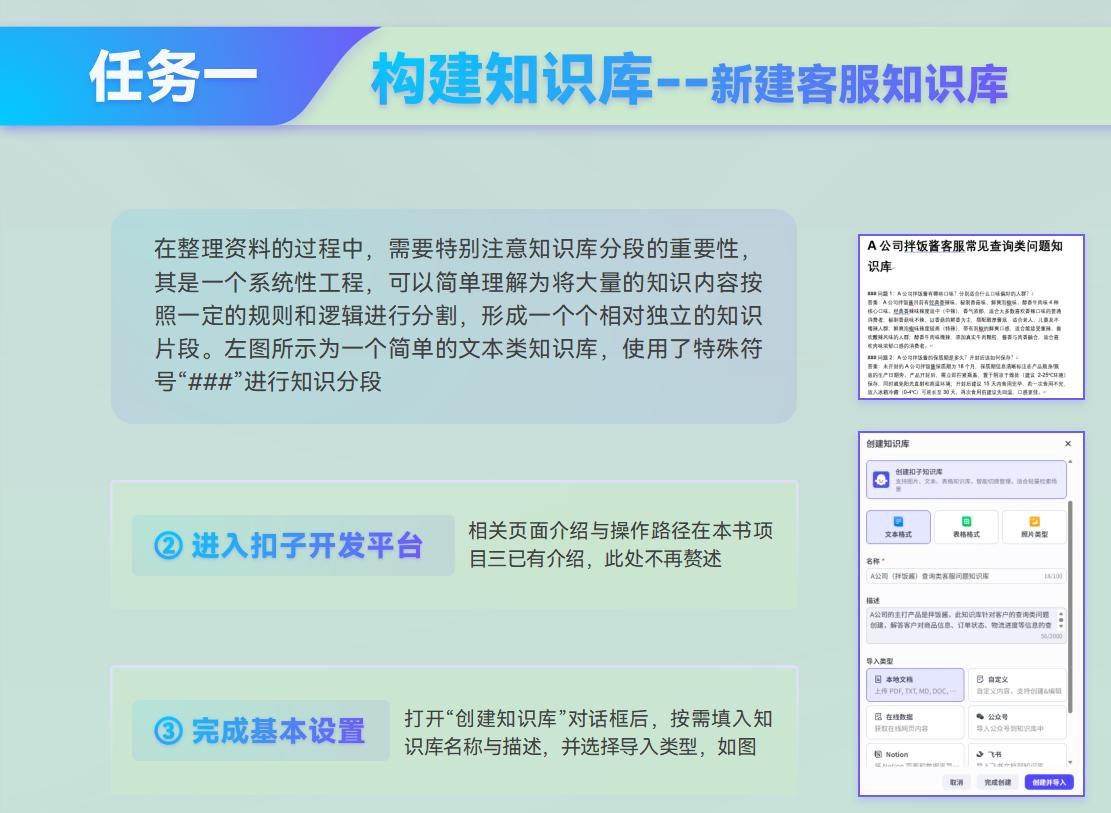
步骤:① 建库(文本/表格/图片)并导入;② 配置召回策略与阈值;③ 写系统提示词(角色/技能/限制/格式);④ 关联知识库预览测试,对比有无库差异;⑤ 记录参数实验。
交付物:知识库截图 + 系统提示词终稿 + 召回参数实验记录。
评分点:知识库配置(25%) · 提示词结构(30%) · 测试对比(30%) · 参数记录(15%)。
🛠 分步操作 · 为项目创建知识库并编写提示词
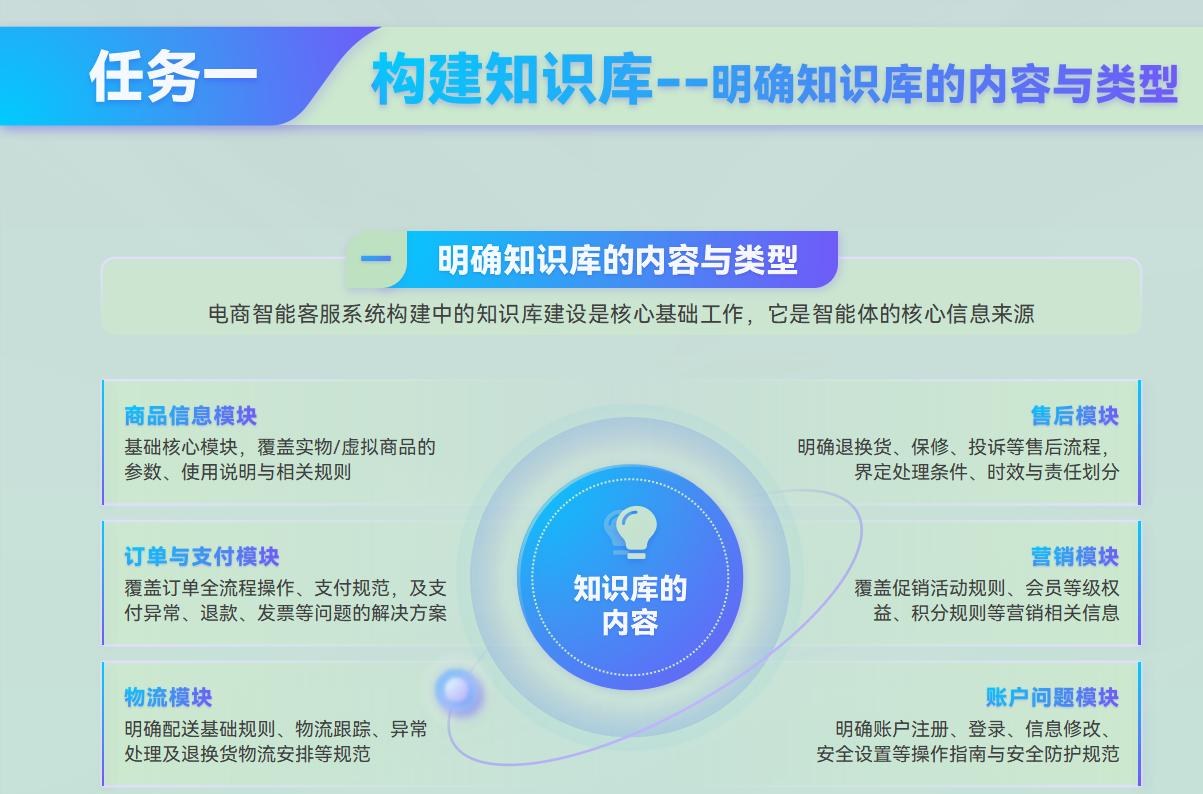
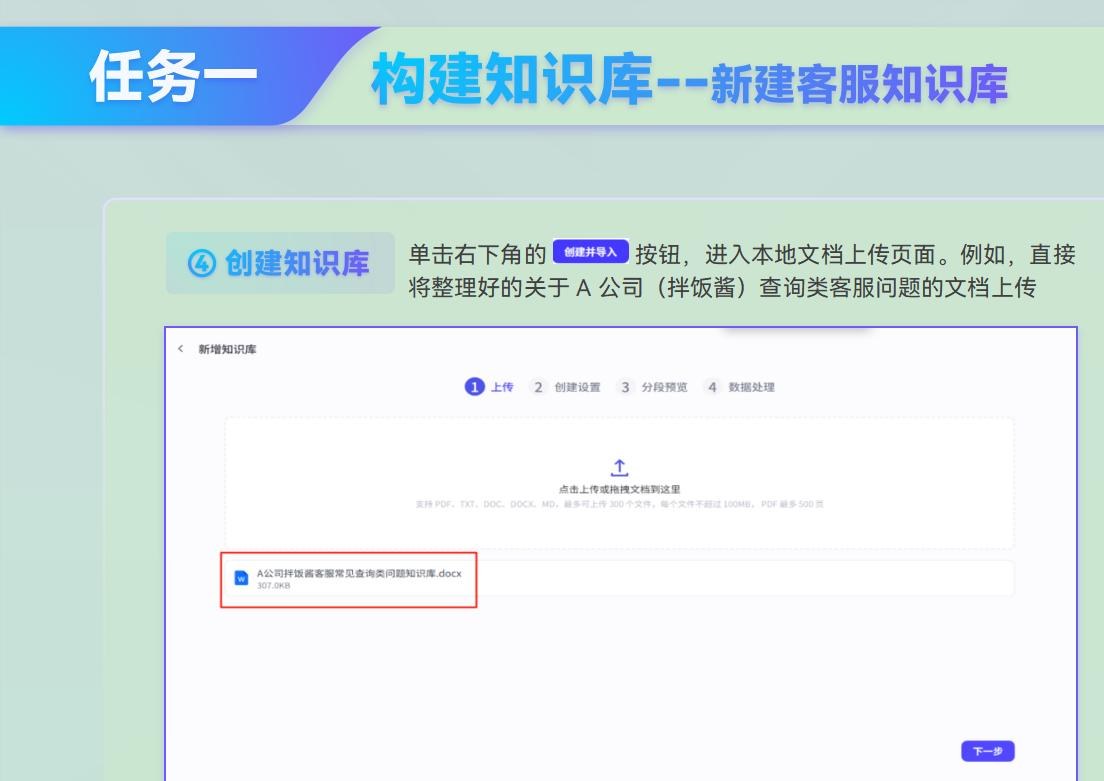
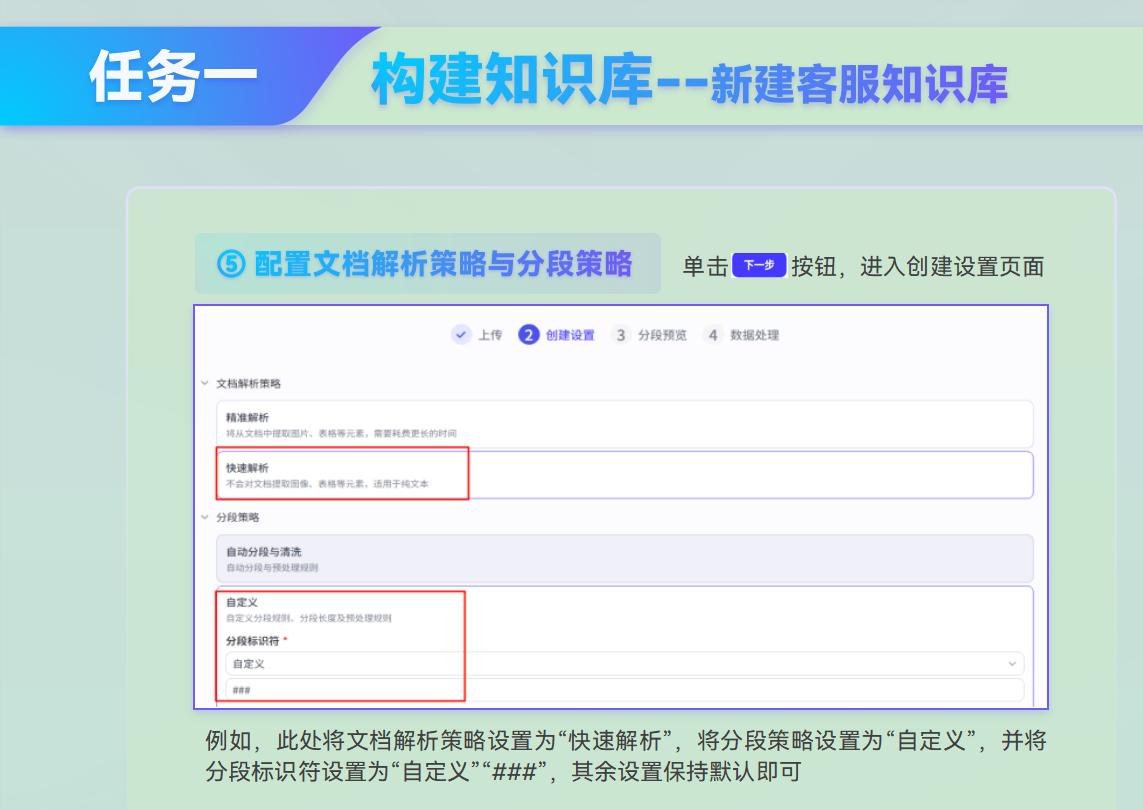
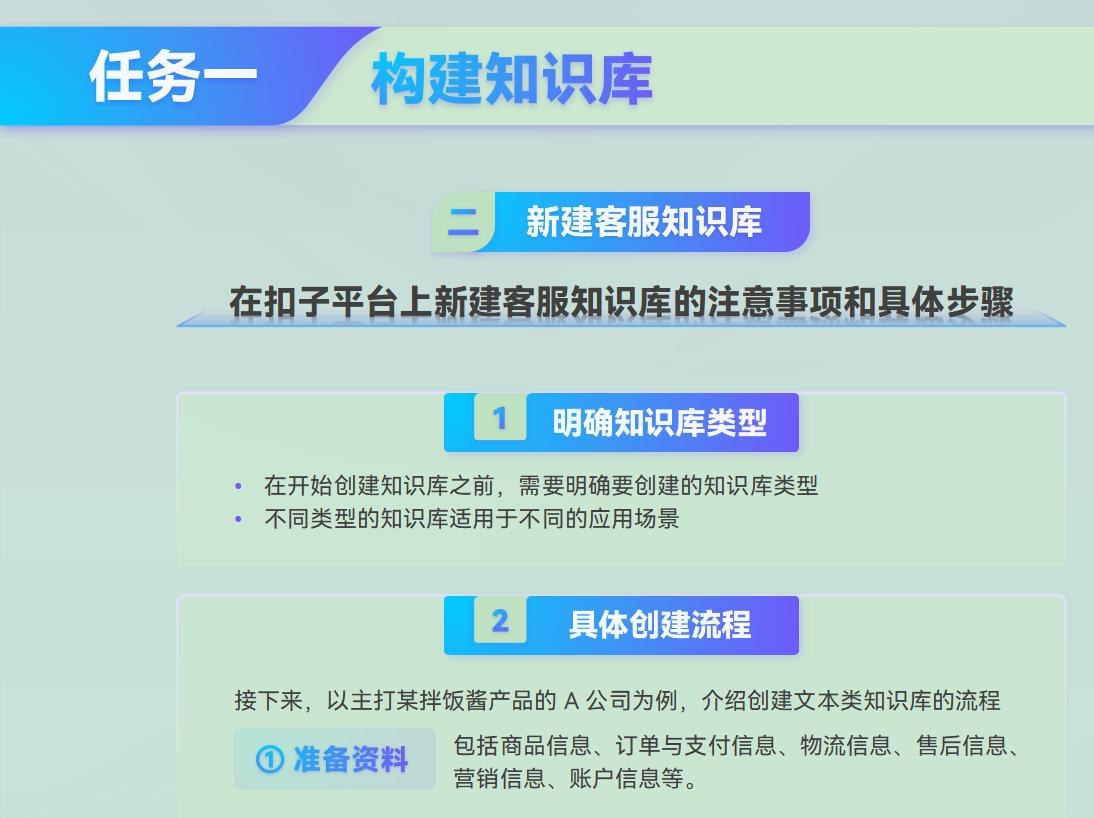
动手 · 分步操作- 准备一份领域资料(手册/表格/图片),在 Coze 创建对应类型知识库并导入。
- 配置召回策略(混合/语义/全文)、最大召回数量与最小匹配度。
- 编写系统提示词:角色 + 技能 + 限制 + 格式,可套用 KB 角色提示词模板。
- 在智能体中关联知识库,预览测试;对比"无知识库"与"有知识库"的回答差异。
- 调整召回参数,观察同一问题检索结果的变化。
📝 系统提示词模板(知识型助手)
# 角色
你是[领域]专家助手,基于知识库严谨作答。
## 技能
1. 检索知识库并引用来源 2. 按用户语言回答
## 限制
- 仅基于知识库内容,缺失则明确说明
- 不编造数据,给出可追溯引用
## 回复格式
结论 → 依据(引用) → 提示
🔬 扩展实验(选做 2–3 项,巩固本章学法)
扩展实验 1 · 提示词模板库工程
任务:为你章内场景设计 3 套提示词模板(角色/任务/约束)。
交付:对比效果,费曼式讲清「模板为何提效」,录屏演示。
扩展实验 2 · 分层索引检索
任务:给知识库建「摘要层 + 原文层」两级索引,测试命中率差异。
交付:录屏总结分层检索何时优于平铺检索。
扩展实验 3 · 问答评估评测
任务:用 10 条问题评估 RAG 回答质量(相关性/准确性)。
交付:录屏讲解「如何判断知识库够不够好」,给出改进项。
🎮 课堂互动小游戏 · 边玩边学
第四部分 本章小结
本章小结
核心要点回顾
- 提示词 = 角色 + 技能 + 限制 + 格式,需持续迭代。
- 系统/用户提示词职责不同,前者稳定影响全局。
- RAG:检索→增强→生成,抑制幻觉、提升专业度。
- 知识库三类:文本/表格/图片,各适其场景。
- 召回查全、排序查准,共同决定回答质量。
- 下一章:记忆与多模态——让智能体记住用户、看懂世界。
延伸阅读:ima 知识库《大模型 Prompt 提示词编写指南》《万字长文讲清 Prompt·Skill·MCP·Agent》;DIKW 与数据建模相关教材;上下文工程指南。
拓展案例 · 恒丰银行 Data Agent
案例 B5-03 Data Agent 激活企业数据生产力
申报单位:杭州网易智企科技有限公司
在金融行业数字化转型深化的背景下,银行业虽拥有海量数据资产,却普遍面临"数据丰富、洞察贫瘠"的治理困境。恒丰银行作为中国12 家全国性股份制商业银行之一,以"建设一流数字化敏捷银行"为战略目标,携手网易智企基于数帆DataAgent 产品"网易知数",打造"恒丰银行绩效助手"数字员工。该智能体构建覆盖数据层、AI 层、触达层、交互层的智能问数体系,基于银行私有化大模型部署,通过角色化Prompt 实现多维度绩效解读,支持PC 端自主用数平台与移动端即时通讯工具"丰秘"双入口触达。
看点:恒丰银行的“绩效助手”把知识库的三个关键决策摊开给我们看:指标口径要不要先治理?Prompt 要不要按角色定制?答案要不要带来源?这三点决定了 RAG 系统是“能问”还是“可信”。
延伸思考题
- 恒丰银行在 POC 阶段横向对比 16 家主流数据厂商,评估维度含产品架构、AI 能力成熟度、数据体系兼容性、实施难度、安全合规与长期演进潜力。请把它改写成本章的“知识库选型评估表”,并补充你认为缺失的两项指标。
- 案例采用“角色化 Prompt(如个贷客户经理视角)”生成绩效解读。请为一个“班主任视角的班级学情解读”写一段角色化提示词,须包含角色、任务、约束、输出格式四要素。
- 若知识库中同时存在“绩效指标口径说明”(长文本制度)与“月度绩效明细表”(结构化表格)两类文档,你会如何设计分块策略与元数据?说明原因。
-
Khattab et al.《DSPy: Compiling Declarative Language Model Calls into State-of-the-Art Pipelines》(ICLR 2024)
用“编程+编译”替代手搓提示词;与第5章提示工程/RAG 互补